#人声分离 V8简介
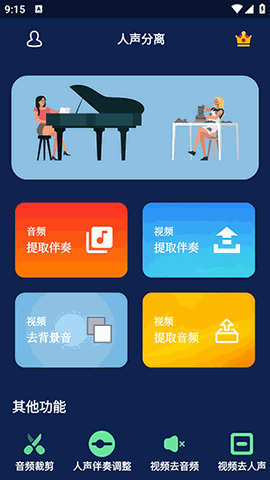
本文介绍一款高效智能的人声分离工具,它采用先进的深度学习算法,能够精准地将音频文件中的人声与各种伴奏、背景音效分离开来,生成独立的音轨。该过程完全自动化,无需专业音频知识,为用户在音乐制作、内容创作等领域提供了极大的便利。
软件说明
1. 核心基于最新的人工智能分离模型,对复杂混音有出色的解析能力。
2. 支持包括MP3、WAV、FLAC在内的多种常见音频格式上传与处理。
3. 处理后可直接预览、下载独立的人声和伴奏文件,操作链路简洁。
4. 提供基础免费的分离次数,满足日常轻度使用需求。
人声分离怎么用
1. 访问工具页面,点击上传按钮,选择本地需要处理的音频文件。
2. 系统自动解析并处理,期间可实时查看分离进度,通常耗时仅需数分钟。
3. 处理完成后,分别试听生成的人声轨道和伴奏轨道,确认效果。
4. 最后,一键下载两个独立的音频文件至本地设备即可完成全部流程。
软件亮点
1. 分离精度高,能有效保留人声细节,同时最大程度减少伴奏残留。
2. 处理速度迅捷,大幅缩短了传统手动分离所需的时间成本。
3. 用户界面友好,三步即可完成核心操作,学习成本几乎为零。
4. 在云端完成运算,不占用本地计算资源,对用户设备配置无要求。
适用场景
1. 音乐翻唱与学习:快速提取歌曲原版伴奏,用于个人演唱或乐器练习。
2. 视频内容创作:从影视片段中分离纯净对白或环境音,便于二次剪辑。
3. 音频素材处理:为播客、有声书清除不必要的背景音乐,突出人声。
4. 娱乐与混音:制作专属的串烧音乐或Remix版本,激发创作灵感。
#人声分离 V8截图